メルセンヌ素数で”FLOPS vs. Memory Bandwidth”を体験する


 50番目のメルセンヌ素数が見つかった,つーか,素数であることの検証が済んだ,という記事に呼応して下記のようなTweetをした。

 これって,”FLOPS vs. Memory Bandwidth”に通じる話でもあるなと思ったので,ここでもう少し詳細にメモっておく。上記のTweetより少し手直ししたプログラムは下記の通り。

// Mersenne Prime Number Calculator by GNU MP
// Copyright (c) 2018 Tomonori Kouya
//
// Compile: cc mpz_mersennne.c -lgmp
//
#include <stdio.h>
#include <stdlib.h>

#include "gmp.h"

/* Mersenne Prime Number */
/* 2^p - 1

/* cf.) http://primes.utm.edu/mersenne/ */

int max_index = 50; // 2018-01-05
unsigned long known_mersenne_prime_p[] = {
	       2,        3,        5,        7,       13,       17,       19,       31,       61,       89, \
	     107,      127,      521,      607,     1279,     2203,     2281,     3217,     4253,     4423, \
	    9689,     9941,    11213,    19937,    21701,    23209,    44497,    86243,   110503,   132049, \
	  216091,   756839,   859433,  1257787,  1398269,  2976221,  3021377,  6972593, 13466917, 20996011, \
	24036583, 25964951, 30402457, 32582657, 37156667, 42643801, 43112609, 57885161, 74207281, 77232917 \
};

int main(void)
{
	mpz_t a;
	int index;

	mpz_init(a);

	// input
	fprintf(stderr, "2^p[index] - 1 = ? ");
	fprintf(stderr, "index(1 - %d) = ", max_index);
	scanf("%d", &index);
	if((index > max_index) || (index <= 0))
	{
		fprintf(stderr, "ERROR: index = %d is illegal!\n", index);
		return EXIT_FAILURE;
	}

	index--;
	printf("p[%d] = %ld\n", index + 1, known_mersenne_prime_p[index]);

	// a := 2^p - 1
	mpz_ui_pow_ui(a, 2UL, known_mersenne_prime_p[index]);
	//gmp_printf("2^%ld     = %Zd\n", known_mersenne_prime_p[index], a);
	mpz_sub_ui(a, a, 1UL);
	gmp_printf("2^%ld - 1 = %Zd\n", known_mersenne_prime_p[index], a);

	mpz_clear(a);

	return 0;
}

 Tweetに挙げたのは\(2^p\)(mpz_ui_pow_ui関数で計算)と\(2^{p – 1}\)(mpz_sub_ui関数で計算)の両方をファイルに書き出す奴だったので,後者のみ書き出すようにするとほぼ半分の時間で済む。
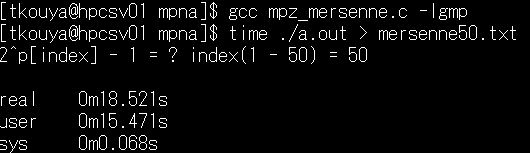
 10進数テキストで書き出すと大体45MBぐらいのファイルになる訳だが,ネット越しだとダウンロードする方が時間がかかる。100BASE-TXの環境でもイーブン。大体,計算そのものにかかる時間よりファイルに書き出す時間の方が問題で,更に言うと,メインメモリ内部のデータ移動の法に時間が費やされている。128MBぐらいのL3キャッシュがあれば,FLOPS(この場合は整数演算だからMIPSだけど)上げるよりもずっと高速に計算終了している筈で,さらに言えば,ファイルに書き出しせずにオンメモリで済むならもっと高速。つまりCPU内部の演算効率よりメモリ帯域(memory bandwidth)の方がよっぽど問題,というお話になるわけで。

 という自分用メモ。

[2018-01-26(Fri) 追記] 「多倍長数値計算入門(仮)」執筆開始につき,上記のCプログラムをJuliaスクリプトで書き直してみた。なーるほど,これは使いやすいや。

#  Mersenne Prime Number Calculator by GNU MP
#  Copyright (c) 2018 Tomonori Kouya
# 
#  Run: julia mersennne.jl 
# 

# Mersenne Prime Number
# 2^p - 1

# cf.) http:# primes.utm.edu/mersenne/

max_index = 50; #  2018-01-05
known_mersenne_prime_p  = [
	       2,        3,        5,        7,       13,       17,       19,       31,       61,       89,
	     107,      127,      521,      607,     1279,     2203,     2281,     3217,     4253,     4423,
	    9689,     9941,    11213,    19937,    21701,    23209,    44497,    86243,   110503,   132049,
	  216091,   756839,   859433,  1257787,  1398269,  2976221,  3021377,  6972593, 13466917, 20996011,
	24036583, 25964951, 30402457, 32582657, 37156667, 42643801, 43112609, 57885161, 74207281, 77232917
];

#  input
print("2^p[index] - 1 = ? ");
print("index(1 - $max_index) = ");
index = parse(Int, chomp(readline(STDIN)));
if (index > max_index) || (index <= 0)
	print("ERROR: index = $index is illegal!\n");
	return EXIT_FAILURE;
end

println("p[$index] = ", known_mersenne_prime_p[index]);

#  a := 2^p - 1
a = BigInt(2)^known_mersenne_prime_p[index] - 1;
println("2^", known_mersenne_prime_p[index], " - 1 = $a");

2018年1月1日(月・祝)?

 明けましておめでとうございます。本年もよろしくお願い致します。

 昨年は殆ど更新しなかったが,今年はせめて週報とか月報程度のことは書いていきたいものである。遅ればせながら英語やり始めたり,「LAPACK/BLAS入門」の出張講義したり(PDF),出るあてがあるんだかないんだか分らん本のリライトを始めたりして,年なりにできることをチマチマやってきたので,本年はそれを継続していきたい。

 ま,守れないのはいつものことだが,年初ぐらいは抱負を語るのも悪くないかな。ともかく,今後ともよろしくお願い致しまする。

8/12(土) 駿府・?

 今週は月曜日午後から職場がロックアウトされているので,自宅でシコシコダラダラ過ごす。積ん読していた漫画類をほぼクリアした以外は,神さんとWindowsマシンとワシの自宅MacBook AirをWindows 10 1703にアップデートする作業に費やしていた。

 神さんのマシンはWin10化していたのだが,何故だか7月のupdateしてたらブート途中でブルースクリーンになる症状が出てオジャンになっていたのを,Windows 7に戻してから(Office 2010 Personal入れなきゃならんので)改めてWindows 10にするという,途中のUpdate時間だけがやたらにかかる作業。ハードウェアのトラブルではないらしく,HDDは正常だったので原因は不明だが,一応元に戻せたのでよしとする。一つ感心したのは,Windows 10のライセンスは,以前,無料アップデート期間中にWin7 -> Win10にした時にアクティベーションしたものがそのまま使えたこと。当たり前のことなんだけど,改めてライセンス取り直しで金払うとなればアホらしいからねぇ。

 ワシのMacBook Airは,Boot Camp環境のWin 8.1を10にしたこと。そのままアップデートできればよかったのだが,あいにくDreamSparkのWin8.1 Enterprise版を入れてしまっていたので,Win10のEnterprise版にするには改めてクリーンインストールせねばならず,それならばPro版にしておこうということで改めてインストールし直ししたのであった。

 結局2台ともクリーンインストールではあったが,古い環境を一掃できたのはよかったかなと。Cloud時代になって,必要なデータファイルはiCloud,Google Drive(Backup & Sync),OneDriveに入れてあるのも幸いした。おかげでmacOS SerraでもWin10でもアプリさえ入れなおせばすぐに作業が続けられるのも時代であるなぁとシミジミ。

 そういえば,今日はVPSへ移動させたワシのWebアプリをPerl CGiからPHPに変換したのであった。今更Perl CGI環境を維持したところで良いことないし,セキュリティ的にもイヤ。時代的にもPHPは必要最小限,サーバ側のデータ入出力だけにとどめ,殆どのUIはJavaScriptで実装という流れだし,Webアプリもどんどん分業化が進む昨今である。

 ボチボチ寝ます。

破綻する区間演算の事例


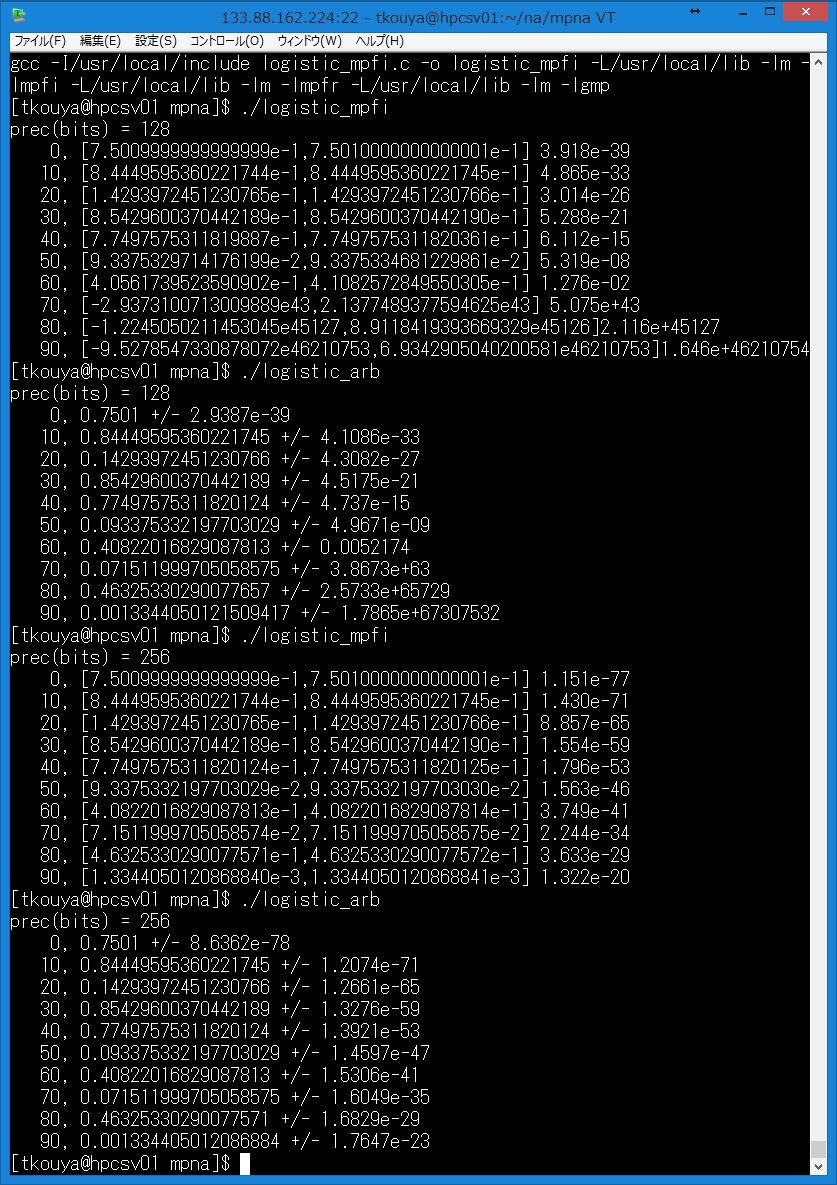
 精度保証計算(という言葉はあまり好きではないのだけれど)の事例も紹介しようかと,ARB(半径)とMPFI(区間)を使ってロジスティック写像\(x_{i+1} := 4x_i(1-x_i)\)の計算をさせてみたところ,桁数が足りないと破綻することが分かった(今更)。つーことで,128bits計算の事例(上)と256bitsの事例(下)をば。

 有効桁数がなくなった途端に区間や半径が急激にデカくなって破綻していることが一目でわかるのはいいとして,精度はともかく計算は最後まで実行したい時には使えん。とりあえず,こういう桁落ちが酷い事例には区間演算だろうとそうでなかろうと桁数増やしてやんなさいという結論になるな。

 あと,実係数2次方程式の事例も作ってみたが,判別式で実数解と複素数解の区別をするif文をどうしようとか,実用に当たってはやはりメンドクサイことを考えないといけないのでその辺をどうかして工夫すると研究になる訳で,こっから先は精度保証の方々にお任せしようっと。まぁ「最初から複素係数でやれ」という結論になるんだろうけど,それはARBの演習問題にしておけばいいか。

 つーことで,使用したプログラム(logistic_arb.c, logisitc_mpfi.c)を最後に掲載しておく。使用時にはARB, MPFIの他,MPFR/GMPが必要。

// logistic 写像
// ARB版
#include <stdio.h>
#include "arb.h"

int main()
{
	int i;
	slong prec;
	arb_t x[102];

	// 初期化
	for(i = 0; i < 102; i++)
		arb_init(x[i]);

	printf("prec(bits) = "); scanf("%ld", &prec);

	// 初期値
	//x[0] = 0.7501;
	arb_set_str(x[0], "0.7501", prec);

	for(i = 0; i <= 90; i++)
	{
		if((i % 10) == 0)
		{
			printf("%5d, ", i);
			arb_printd(x[i], 17);
			printf("\n");
		}

		//x[i + 1] = 4 * x[i] * (1 - x[i]);
		arb_sub_ui(x[i + 1], x[i], 1UL, prec);
		arb_neg(x[i + 1], x[i + 1]);
		arb_mul(x[i + 1], x[i + 1], x[i], prec);
		arb_mul_ui(x[i + 1], x[i + 1], 4UL, prec);

	}

	// 消去
	for(i = 0; i < 102; i++)
		arb_clear(x[i]);

	return 0;
}
// logistic 写像
// MPFR & MPFI版
#include <stdio.h>
#include "mpfr.h"
#include "mpfi.h"

int main()
{
	int i;
	unsigned long prec;
	mpfi_t x[102];
	mpfr_t relerr;

	printf("prec(bits) = "); scanf("%ld", &prec);
	mpfr_set_default_prec(prec);

	// 初期化
	mpfr_init(relerr);
	for(i = 0; i < 102; i++)
		mpfi_init(x[i]);

	// 初期値
	//x[0] = 0.7501;
	mpfi_set_str(x[0], "0.7501", 10);

	for(i = 0; i <= 90; i++)
	{
		if((i % 10) == 0)
		{
			printf("%5d, ", i);
			mpfi_out_str(stdout, 10, 17, x[i]);
			mpfi_diam(relerr, x[i]);
			mpfr_printf("%10.3RNe\n", relerr);
		}

		//x[i + 1] = 4 * x[i] * (1 - x[i]);
		mpfi_ui_sub(x[i + 1], 1UL, x[i]);
		mpfi_mul(x[i + 1], x[i + 1], x[i]);
		mpfi_mul_ui(x[i + 1], x[i + 1], 4UL);

	}

	// 消去
	mpfr_clear(relerr);
	for(i = 0; i < 102; i++)
		mpfi_clear(x[i]);

	return 0;
}

GNU MP(GMP)マニュアル翻訳日記(最終)


 「GMP」だと全然関係ない分野の略語と被ることが多いようなので,「GNU MP」も併記して書くことにしようっと。そういえば「gmp_ja」で検索するとこちらの方のページが既にあったことに気づかされたのでご紹介しておく。GNU MPを全然知らん方は目通ししてから拙訳(HTML,PDF,ソース)を読むことをお勧めします。

 さて,翻訳完了から日が経つと忘れそうなことを書きつけておく。

1.GMPの開発チーム
 って表紙(PDF)に書いてあるんだもんな,誰だか知りたくなるってもんであるが,これについてはAppendix Aにまとめてある。ズラズラ時系列的に並べてあるけど,Tröbjorn以外の主要人物を抜き出すと,Paul Zimmermann(仏,MPFR開発陣の一人でもある),Kevin Ryde(豪,Perl ModuleやEmacsスクリプト著作多数),Niels Möller(瑞),Marco Bodrato(伊,Toom-Cookアルゴリズムに詳しい),Marc Glisse(仏,最近ではmini-gmpの提唱と実装)あたりが主要開発者ということになる。今でもGMPのMLでお見かけするメンツで,保守管理もマメにやり,中核人物の狷介さを和らげるクッションにもなっているわけで,実力もさることながら人間的も優れている(MLを見る限りだけど)貴重な人材である。

2.イマイチ理解できてない部分
 やっぱり最後の「アルゴリズム」の章が難物で,ここについては数論アルゴリズムと各CPUのアーキテクチャに通じている方(つーたら日本だとかなり稀少な部類な絶滅危惧種)にリライトか再翻訳をお願いしたい。特にアセンブラで書かなきゃいけなくなった理由である「桁上がり・桁借り上げ処理」(素直に「キャリー操作」の方が良かったかな・・・),「ループ展開」,「アセンブラコードの書き方」なんて,実際にアセンブラ職人になってシコシコとマイクロ秒単位のチューニングを体験しないことにはスッキリ訳せないよ! GMPマニュアルの翻訳は十数年来挫折しまくってきたけど,原因はこの辺りの解読に自信が持てないからだったりする。とはいえ,もういい加減イイ歳なので恥だろうが何だろがやっておかないと後悔するとばかりにえいやっと直訳してみたのである。とゆーことでリライトをやってくれる貴重な人材求む!

3.Texinfoとmakeinfo
 TexinfoについてはTrueRoadさんのパッケージを一部利用させて頂いたが,W32Tex環境では通らない部分があって,結局,Ubuntu 16.04にtexlive2016をフルで突っ込んでxetex使ったら何とかPDFは生成できた。この辺,最近のTeX環境に疎いのでよー分からん。HTML化もUbuntuのmakeinfo –htmlで生成。こちらはスムーズにできた。今時デカい文書をTexinfo使う方が珍しいのかしらん?
 次はMPFR 4.0のTexinfoを処理する予定なんだが,まぁ当面は上記のように処理することになりそうである。TexnicianじゃないのであまりTexinfo辺で苦労したくないんで,本来ゴシックにすべき部分も明朝になってたりするけど,この辺でご勘弁を。

4.翻訳の意義
 今時は「ない」と断言してもいいんじゃないのかな。既に古いMPFRやQDの翻訳やってみたけど,ワシの場合は完全に自己満足,オナニー的なものである。Web公開しているのはGoogleという世界最高の検索ツールが使いたいからであって,備忘録以上の意味はない。ワシの業績リストにも一切入れてないし(何人かの方からお褒めの言葉は頂いたけど)。ただ,「一通り読んでみましたよ」ぐらいの意思表示はできるかなと。多倍長数値計算の基本ライブラリであるMPFR,QD,GMPぐらいはマニュアルぐらい一通り読んでおかないとこの辺の専門家でございなんて言えないし,この辺の後追いをやるにしても,先人の業績を参考文献に使うぐらいの節度は欲しいし,参考文献に入れるなら「全部読んだ」ぐらいのことは言いたいしねぇ。
 GMPについては,もう当分これを超える多倍長自然数演算カーネルは出てこないだろうなと思うし,GPUではカーネルでmalloc/freeを繰り返すと覿面に遅くなるんで,MPNカーネルそのままの移植は向いてないだろうと感じる。CUMPは今んとこbasecase演算にとどまっているし,テンポラリメモリは固定で取ってるので,これそのままだとKaratsubaやToom-Cookの移植は大変そうである(割算だけ移植して挫折した奴がここにいる)。何にせよ,多倍長精度を素直にサポートするライブラリとしてはエベレスト的存在がGMPなので,当面この方向での進化もさしてなさそうに思える。
 GMP自体,Version 4以降はアーキテクチャの進化に追随しているだけで(それだけでも大したもんなんだけど),アルゴリズム的な大幅改善はない。Version 5はあっという間にVersion 6になっちゃったけど,メジャーバージョンアップの割には新規性はかなり薄い(だもんで不満も多少でてた)。どん詰まりっぽい状況だから,マニュアル翻訳も今やっておけばさほど古びずに済みそうという予想があってやっている訳である。オナニーなら性欲のあるうちじゃないと詰まらんしねぇ。

 とりあえず,こんなもんかしら? 後はどなたかに(翻訳する人がいれば)お任せする。